La distinction à poser d’emblée
Poids accessibles n’est pas open source
Un modèle dont les poids sont téléchargeables n’est pas automatiquement un modèle open source.
Quatre éléments sont à examiner avant d’employer le terme : la licence, l’accès au code, les informations sur les données et le processus d’entraînement, et les droits de modification et de redistribution. C’est la première chose que le laboratoire enseigne, parce que c’est la confusion la plus répandue — et la plus coûteuse, lorsqu’une institution découvre après déploiement ce que sa licence lui interdit.
La référence de cadrage retenue est la définition de l’IA open source publiée par l’Open Source Initiative.
Trois ambitions
Former
Des professionnels compétents et responsables.
Construire
Un laboratoire d’expérimentation et d’innovation.
Industrialiser
Des solutions utiles aux entreprises et aux institutions africaines.
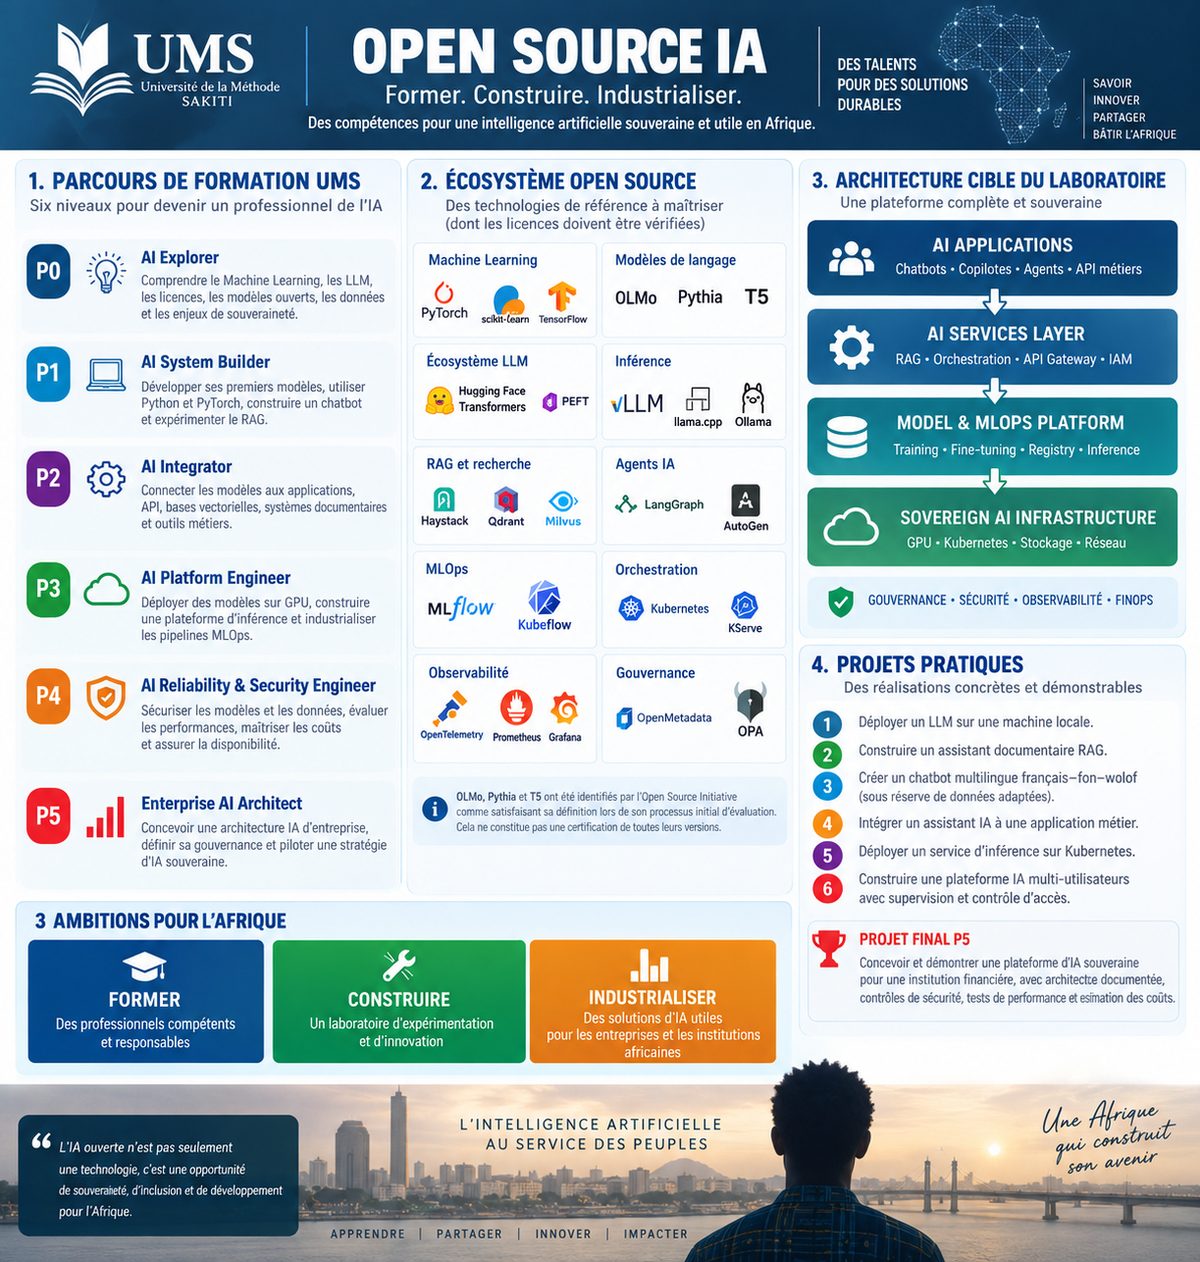
Six niveaux
| Niveau | Compétences visées |
|---|---|
| P0 | AI Explorer — apprentissage automatique, modèles de langage, licences, modèles ouverts, données et souveraineté |
| P1 | AI System Builder — premiers modèles, construction d’un assistant conversationnel, première expérimentation de génération augmentée par la recherche |
| P2 | AI Integrator — connecter modèles, interfaces, bases vectorielles, systèmes documentaires et applications métiers |
| P3 | AI Platform Engineer — déployer sur processeurs graphiques, construire une plateforme d’inférence, industrialiser les chaînes de traitement |
| P4 | AI Reliability & Security Engineer — sécuriser modèles et données, évaluer les performances, maîtriser les coûts, assurer la disponibilité |
| P5 | Enterprise AI Architect — concevoir l’architecture d’entreprise, définir sa gouvernance, piloter une stratégie souveraine |
L’écosystème à explorer
Des pistes d’étude, domaine par domaine — et non une pile recommandée.
| Domaine | Projets et outils à étudier |
|---|---|
| Apprentissage automatique | PyTorch, scikit-learn, TensorFlow |
| Modèles de langage | OLMo, Pythia, T5 |
| Écosystème de modèles | Hugging Face Transformers, PEFT |
| Inférence | vLLM, llama.cpp, Ollama |
| Recherche augmentée | Haystack, Qdrant, Milvus |
| Agents | LangGraph, AutoGen |
| Industrialisation | MLflow, Kubeflow |
| Orchestration | Kubernetes, KServe |
| Observabilité | OpenTelemetry, Prometheus, Grafana |
| Gouvernance | OpenMetadata, Open Policy Agent |
La présence d’un outil dans cette liste ne vaut ni validation technique ni certification de licence. Chaque composant et chacune de ses dépendances doivent être vérifiés. Concernant les modèles cités : ils ont été identifiés par l’Open Source Initiative comme satisfaisant à sa définition lors de son processus initial d’évaluation — ce qui ne constitue pas une certification de toutes leurs versions.
La méthode de sélection et la cartographie s’appliquent ici comme aux autres domaines : besoin, exigences, maturité, preuve, décision tracée.
L’architecture cible
Quatre couches, et quatre préoccupations transverses.
| Couche | Ce qu’elle porte |
|---|---|
| Applications | Assistants conversationnels, copilotes, agents, interfaces métiers |
| Services | Recherche augmentée, orchestration, passerelle d’interfaces, gestion des identités |
| Plateforme de modèles | Entraînement, spécialisation, catalogue de modèles, inférence |
| Infrastructure souveraine | Processeurs graphiques, orchestration, stockage, réseau |
| Transverse | Gouvernance, sécurité, observabilité, maîtrise des coûts |
Architecture pédagogique cible. Ce n’est pas la description d’une plateforme déjà déployée.
Six projets, puis une démonstration
- 01Déployer un modèle de langage sur une machine locale
- 02Construire un assistant documentaire par recherche augmentée
- 03Créer un assistant multilingue français, fon et wolof — sous réserve de disposer de données adaptées
- 04Intégrer un assistant à une application métier
- 05Déployer un service d’inférence orchestré
- 06Construire une plateforme multi-utilisateurs avec supervision et contrôle d’accès
Le projet final. Concevoir et démontrer une plateforme d’intelligence artificielle souveraine pour une institution financière : architecture documentée, contrôles de sécurité, tests de performance et estimation des coûts. Quatre livrables, dont aucun n’est une présentation.
Ce que le laboratoire produit
- ·Un référentiel de compétences par niveau
- ·Des travaux pratiques reproductibles et documentés
- ·Un dépôt de code et des configurations d’infrastructure par projet
- ·Des preuves de validation : démonstrations, tests, revues d’architecture
- ·Un dossier de projet final : architecture, exploitation, sécurité, coûts
Ce document est un cadrage
Les technologies citées sont des pistes à évaluer. Les licences et les conditions d’utilisation de chaque version doivent être vérifiées avant toute adoption. Les niveaux, durées et projets constituent une proposition pédagogique, non une certification ni une norme externe.
Ce que ces compétences permettent de conduire
La démarche AI-Ready Enterprise applique ces six niveaux à une mission en entreprise : dix chantiers de préparation, sept questions de diagnostic, et quatre formats d’intervention.
Le laboratoire voisin
L’Open Source Enterprise Lab applique la même progression en six niveaux au système d’information d’une entreprise. Les deux laboratoires partagent leur socle : orchestration, identités, observabilité, gouvernance.
L’auteur
Lionel Sakiti
Program Manager Cloud & IA souveraines. Il travaille sur les infrastructures de paiement, les programmes de cloud et d’intelligence artificielle souverains et la gouvernance des données dans la zone UEMOA.